Avant même que l’écran d’accueil soit monté, l’application consacrait une part importante de son temps JavaScript à détecter des capacités de formatage. Le polyfill restait nécessaire ; sa détection était disproportionnée. Sur l’Android d’entrée de gamme testé, corriger cette seule détection a réduit de 22 % le délai jusqu’au jalon alors suivi.
L’enquête a ensuite traversé les imports, les abonnements au store, le rendu React et la compilation Android. Certaines corrections ont produit un gain mesurable, d’autres ont révélé un problème de protocole ou déplacé l’attente vers une autre étape.
Ce retour d’expérience est anonymisé. Les exemples décrivent les mécanismes sans reproduire le code de l’application.
Les étapes d’un cold start React Native sur Android
Un cold start part d’un processus qui n’existe pas encore. Sur une app React Native, le temps se répartit entre ces étapes :
- Création du processus. Android lance le processus et crée l’objet
Application. SononCreate()charge les bibliothèques natives de React Native et initialise souvent plusieurs SDK. - Activité et écran de démarrage. L’activité principale est créée pendant que le système affiche l’écran de démarrage (splash).
- Runtime JavaScript. Hermes charge le bundle. En release, il est déjà compilé en bytecode : rien à analyser, mais chaque module importé au démarrage s’exécute, avec ses polyfills et ses effets de bord.
- Premier rendu. React rend l’arbre initial, React Native crée les vues natives et l’activité affiche sa première image : c’est le TTID (time to initial display).
- Écran utilisable. Session, profil, feature flags, données de l’accueil : l’écran se complète, souvent après des requêtes. Quand l’app le juge prêt, elle appelle
reportFullyDrawn(): c’est le TTFD (time to full display).
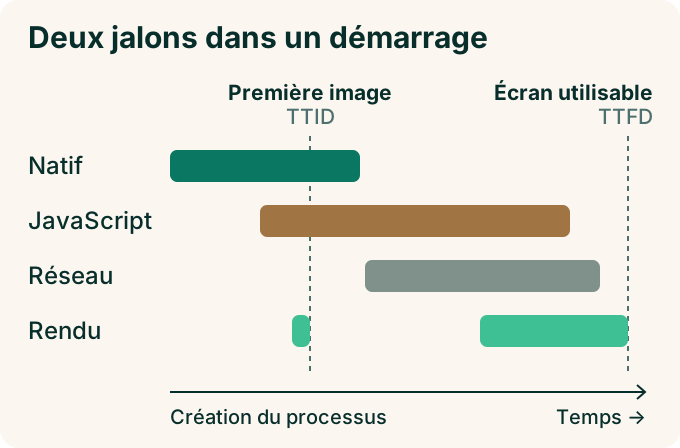
Schéma de principe, sans échelle de temps. Le placement exact des jalons dépend de l’application.
Ces étapes se recouvrent : raccourcir l’une d’elles n’avance le lancement que si elle était sur le chemin critique. La documentation Android sur le démarrage (nouvelle fenêtre) détaille les deux jalons.
Pour une première lecture, adb shell am start -S -W -n <package>/<activité> arrête l’app, la relance et affiche TotalTime, qui correspond au TTID. C’est utile pour se repérer, pas pour annoncer un gain : la partie sur le benchmark explique pourquoi.
Quand la détection d’Intl ralentit le lancement
Le premier coût important venait de la détection générique de Intl.NumberFormat, notamment de la recherche de locale. J’ai remplacé cette détection par des vérifications des formats réellement utilisés et réutilisé les instances de formatage.
Les appareils testés avaient encore besoin du fallback pour respecter certains regroupements de chiffres. Le gain venait donc du chemin de détection évité. Supprimer le polyfill aurait accéléré le lancement au prix d’un affichage incorrect.
Les tests couvraient les langues prises en charge, les séparateurs, l’arrondi, les formats compacts, les devises et le changement de langue. Le cache d’un formateur doit suivre sa locale et ses options.
J’ai ensuite traité Intl.PluralRules séparément. Hermes ne le fournit pas : le polyfill reste nécessaire, et le charger directement évite une détection coûteuse. FormatJS documente ce cas sur React Native (nouvelle fenêtre). Les observations de cette seconde correction viennent d’un profilage debug : je ne les transforme pas en secondes gagnées en release.
Sur React Native 0.86+ avec la New Architecture, une autre option supprime ce polyfill : hermes-intl (nouvelle fenêtre), maintenu par useffect.sh, fournit Intl.PluralRules, RelativeTimeFormat, ListFormat et Locale en natif via ICU4X. Il n’y a plus de JavaScript à charger ni de détection à faire au lancement. Sur iOS, hermes-intl remplace aussi Intl.NumberFormat (depuis la 0.3.0). Sur Android, ça reste celui d’Hermes, qui s’appuie sur l’ICU du système.
Imports, rendu, abonnements : que faut-il au premier écran ?
Après les polyfills, j’ai regardé ce que l’arbre de dépendances et les composants demandaient au lancement, en me demandant chaque fois quel besoin du premier écran justifiait ce travail. Un écran rarement consulté pouvait déjà faire évaluer ses modules ; un hook appelé pour une seule propriété pouvait installer plusieurs abonnements.
Quels imports et composants peuvent attendre ?
Des écrans peu utilisés étaient évalués dans la chaîne d’imports initiale. Leur chargement différé a réduit le travail avant l’accueil. Le coût est payé lors de la première navigation vers ces écrans, et le bundle distribué ne devient pas plus petit. React Native décrit ces techniques et leurs précautions concernant les effets de bord des modules (nouvelle fenêtre).
J’ai également séparé le contenu essentiel de l’accueil de ses sections secondaires. L’action principale reste disponible ; les blocs secondaires sont montés après la disparition de l’écran de démarrage. Ce délai doit aussi se terminer si l’appel qui masque l’écran de démarrage échoue ou ne rend jamais la main, sinon une partie de l’accueil reste vide.
Après le changement, je vérifie la première navigation, le défilement et l’apparition du contenu différé : avancer un jalon pour bloquer l’utilisateur juste après n’a pas d’intérêt.
Retirer les abonnements inutiles du premier rendu
Un hook qui lit une seule propriété utilisateur installait deux abonnements à des données de profil. Je l’ai ramené à une sélection de la valeur demandée. Un autre hook installait, chez chaque consommateur de feature flag, des abonnements dont la valeur calculée n’était pas utilisée.
Il faut réduire ces abonnements sans casser la fraîcheur des données, le changement de compte ni les règles d’exposition aux expériences.
Les gains mesurés et ce qu’ils couvrent
Choisir le jalon avant de comparer
Le choix du signal de disponibilité est décisif. Une première instrumentation attendait la fin d’une animation décorative pour déclarer l’écran prêt. Elle ajoutait la durée de cette animation au résultat, alors que l’utilisateur pouvait déjà agir.
Les premières campagnes suivaient un signal historique : écran de démarrage disparu et bouton principal positionné. Il ne démontrait ni la disponibilité de tout le contenu, ni la réactivité d’un appui.
J’ai ensuite fait évoluer le signal vers un ensemble de conditions observables : écran d’accueil au premier plan, écran de démarrage disparu, données nécessaires disponibles, élément principal positionné et action principale activée. Un module natif appelle alors reportFullyDrawn(), une seule fois par lancement mesuré : c’est ce qui produit le TTFD. Un appui qui répond se vérifie à part, par un test fonctionnel.
Modifier la définition du signal crée une nouvelle série de mesures. On ne compare pas un ancien résultat incluant l’animation avec un nouveau résultat qui l’exclut pour annoncer une optimisation.
Les premiers résultats
Les chiffres ci-dessous suivent le signal historique. L’indice 100 représente la référence de chaque comparaison ; il ne permet pas de comparer la vitesse des téléphones entre eux.
| Comparaison | Avant | Après | Réduction observée |
|---|---|---|---|
| Formatage des nombres isolé, Android d’entrée de gamme | 100 | 78 | 22 % |
| Ensemble des premières optimisations, même catégorie d’appareil | 100 | 64,5 | 35,5 % |
| Ensemble des premières optimisations, Android plus récent, deux comparaisons | 100 | 53,3 à 66,5 | 46,7 à 33,5 % |
La campagne isolée comptait 40 lancements valides, en quatre blocs A/B/A/B, avec une trace Perfetto par lancement. La campagne cumulée comptait 80 lancements valides sur deux appareils. Ses réductions ne s’attribuent pas à une PR en particulier et ne s’additionnent pas.
Ces résultats ne sont pas directement comparables à ceux du protocole ultérieur, plus strict, décrit plus bas.
Remonter du temps perdu au code responsable
Pour choisir une correction, il faut relier le temps écoulé au travail qui le provoque. Les outils répondent à des questions complémentaires :
| Outil | Question |
|---|---|
| Macrobenchmark | Quand la première image et le signal de disponibilité arrivent-ils ? |
| Perfetto | Quel thread travaille ou attend pendant cet intervalle ? |
| Profilage Hermes | Quelles fonctions et quels modules consomment le temps JavaScript avant le premier écran ? |
Une capture Hermes m’aide à choisir une correction. Le gain final se mesure à nouveau sans ce profilage : les durées d’une capture instrumentée ne sont pas des temps de production.
Quand une requête semble lente à cause du rendu
J’ai aussi ajouté des jalons pour la session, le profil, les feature flags et les données de l’accueil. Attention à leur emplacement : un marqueur émis dans un effet React arrive après du travail de rendu. Il peut attribuer ce retard à la requête qui le précède. Dans le banc de mesure, j’ai distingué le moment où React valide le rendu (le commit) du moment où l’effet s’exécute.
Une « attente de requête » inclut parfois le temps d’attente et de traitement du thread JavaScript. Pour accuser le réseau, il faut confronter cette attente au timing HTTP natif et à l’activité du thread JS.
Une attente supprimée, un démarrage inchangé
Une expérience consistait à utiliser des feature flags en cache plutôt qu’à attendre leur réponse réseau. Une autre condition de démarrage est alors devenue bloquante, et le gain attendu n’est pas apparu. Les tâches se recouvrent, dépendent les unes des autres et se disputent le même thread : leurs durées ne s’additionnent pas. Pour prioriser la suite, il faut identifier celle qui retarde encore le premier écran utile.
Le cache pouvait aussi modifier les variantes présentées et le suivi d’exposition aux tests A/B. Cette piste est restée une expérience, et j’ai continué à travailler sur la charge au démarrage.
R8 et Baseline Profiles : vérifier le binaire livré
Pour ces deux mécanismes, il faut vérifier qu’ils sont actifs dans l’artefact livré, puis qu’ils améliorent le jalon suivi. Un DEX plus petit ou une première image plus rapide ne prouvent pas le second point.
R8 activé, optimisations désactivées
R8 (nouvelle fenêtre) supprime du code Android inutilisé, renomme des symboles et peut optimiser le bytecode. Un build peut exécuter les deux premières opérations tout en désactivant la dernière.
J’ai procédé par étapes : pilote, activation par défaut, puis optimisation du bytecode. Avant AGP 9.0, une règle -dontoptimize fournie par une dépendance suffisait à désactiver l’optimisation de toute l’app, et c’était le cas avec l’outillage du projet. J’ai donc vérifié la configuration fusionnée et ajouté un contrôle sur le résultat du build. AGP 9.0 ignore désormais ces options globales quand elles viennent d’une bibliothèque.
Les appels par réflexion et les points d’entrée JNI demandent des règles de conservation ciblées. La validation inclut les parcours des SDK et la lisibilité des crashs avec le mapping du binaire exact.
Les campagnes du pilote donnaient un signal favorable sur le TTID, mais aucun gain fiable sur le TTFD. La phase d’optimisation réduisait la taille du binaire ; ses mesures de démarrage étaient trop variables pour conclure. Je garde ces résultats séparés.
Un profil présent dans l’APK est-il utilisé par ART ?
Les Baseline Profiles (nouvelle fenêtre) permettent à ART de précompiler les chemins Android décrits par le profil. Ils n’optimisent pas directement le JavaScript exécuté par Hermes.
J’ai ajouté la génération et l’intégration d’un profil. Mais trouver baseline.prof dans l’APK ne suffit pas : il faut examiner l’artefact final, après les transformations des outils tiers, puis contrôler l’état d’installation et de compilation. Android fournit notamment ProfileVerifier (nouvelle fenêtre) pour ce diagnostic.
La première comparaison avait subi une interruption et une dérive thermique. Elle donnait une piste favorable sur la première image, sans établir de gain robuste sur l’écran utilisable. Je ne retiens donc pas de pourcentage pour cette piste.
Un benchmark assez fiable pour décider
Une comparaison A/B n’aide à décider que si le banc de mesure distingue le gain recherché de son propre bruit. Je commence donc par comparer le même APK à lui-même : c’est le contrôle A/A. Un A/A sans écart significatif ne suffit pas : l’intervalle de confiance doit aussi tenir dans une marge fixée à l’avance, par exemple ±5 %. Si le banc varie davantage que l’amélioration recherchée, il faut d’abord le stabiliser.
J’ai utilisé Macrobenchmark (nouvelle fenêtre) pour piloter les lancements Android et conserver les traces. Le build de benchmark reprend la configuration release et ajoute l’instrumentation nécessaire. Le diagnostic JavaScript plus intrusif se fait dans une session séparée.
Chaque comparaison doit préciser ses conditions :
| Élément | Ce que je conserve ou vérifie |
|---|---|
| Binaire | Révision, empreinte de l’APK, signature et configuration de build |
| Appareil | Même téléphone physique, version Android, alimentation et écran déverrouillé |
| Température | État thermique avant et après chaque lancement, refroidissement entre les séries |
| Session | Même compte de test et mêmes données ; premier lancement traité à part |
| Compilation | État ART explicite, identique dans les deux conditions, sauf si c’est la variable étudiée |
| Mesure | Même scénario, mêmes marqueurs, même définition de la disponibilité |
Pour un utilisateur qui revient, je conserve la session et les données entre les lancements. Effacer le stockage à chaque fois mesurerait aussi l’onboarding, l’authentification ou un cache vide.
Une série de dix lancements donne un premier aperçu. Plusieurs séries alternées (A/B/A/B, puis selon les campagnes A/B/B/A et ordre inversé) aident à voir si le résultat dépend de l’ordre. L’alternance atténue certaines dérives, sans neutraliser à elle seule la chauffe ou un backend variable. Je conserve les valeurs par lancement, la médiane et la dispersion par série, ainsi que les causes d’invalidation.
Vérifiez aussi que le cold start est réellement à froid : un service peut avoir recréé le processus avant le lancement mesuré. Une campagne isolée sur l’appareil plus récent a dû être écartée pour cette raison. Demander un lancement à froid à Macrobenchmark ne dispense pas de le vérifier dans les traces.
Isoler la variabilité sans changer le produit
Le banc a distingué trois scénarios :
| Scénario | Ce qu’il permet d’observer |
|---|---|
| Réseau réel, SDK actifs | Le démarrage complet dans les conditions du test, avec leur variabilité |
| Réponses de démarrage figées | Le traitement des mêmes données, en limitant la variabilité des requêtes rejouées |
| Réponses figées et un SDK natif exclu du démarrage | Le travail de l’accueil avec cette source de concurrence retirée |
Le dernier scénario a permis de qualifier une session A/A sur un téléphone : sur 80 lancements, l’intervalle à 95 % restait approximativement entre −3 % et +3 %, dans la marge de ±5 % fixée à l’avance. Cela validait la précision de cette session, pas un gain produit : les autres SDK restaient actifs et le scénario ne représentait plus le démarrage complet en production.
Les réponses figées et les exclusions de SDK appartiennent exclusivement au build de benchmark. Toute optimisation retenue doit ensuite être réévaluée avec le réseau réel et les SDK actifs.
Garder une référence pour la prochaine correction
Pour reprendre le sujet sur une autre application, je garderais cette séquence :
- Définir les conditions qui rendent le premier écran utile et conserver séparément le TTID.
- Produire un build proche de la release et vérifier le démarrage à froid dans les traces.
- Qualifier le bruit avec une comparaison A/A sur téléphone physique.
- Identifier le coût dominant avec Perfetto, puis le profilage JavaScript si nécessaire.
- Modifier une cause à la fois ; vérifier aussi le contenu différé et la première interaction.
- Refaire la comparaison avec le même protocole, en conservant les échecs et leur explication.
- Suivre la version livrée par build et catégorie d’appareil, avec les crashs et ANR. Android vitals ne remonte que le TTID (alerte à partir de 5 s pour un cold start) : pour suivre l’écran utilisable en production, il faut envoyer soi-même le jalon de disponibilité à son outil de monitoring.
En production, un indicateur global mélange encore les utilisateurs qui ont reçu le correctif et ceux qui utilisent l’ancienne version. Je regarde donc d’abord les builds concernés, puis l’évolution avec leur adoption. Les percentiles de production complètent le banc ; ils ne sont pas interchangeables avec la médiane de quelques séries locales.
Ce protocole est celui que nous appliquons dans la partie performance d’un audit d’app React Native. Garder le banc et les traces avec le code permet à l’équipe de repérer une régression sans repartir de zéro.
Questions fréquentes
Hermes suffit-il à accélérer le démarrage ?
Hermes optimise le chargement du JavaScript, notamment grâce au bytecode en release. Il reste à exécuter les modules, initialiser les services, traiter les données et rendre l’écran. Une détection de polyfill coûteuse ou des abonnements inutiles restent du travail, même avec Hermes.
Peut-on mesurer le cold start sur un émulateur ?
Un émulateur aide à vérifier le scénario et à diagnostiquer un problème. Pour annoncer un gain sur téléphone, mesurez sur un appareil physique, avec un build proche de la release et des conditions documentées. Une mesure instrumentée en debug sert à localiser un coût, pas à annoncer un temps de démarrage en production.
Faut-il vider les données entre deux cold starts ?
Pas pour mesurer le retour d’un utilisateur connecté. Un cold start exige un nouveau processus, pas un compte déconnecté ni des données effacées. Le premier lancement après installation est un scénario distinct. L’état de compilation ART doit également être choisi et conservé pour chaque comparaison.
Dix lancements suffisent-ils ?
Dix lancements peuvent former une série de départ. Ils ne garantissent aucune précision. Comparez d’abord le même APK à lui-même, sur plusieurs séries, puis augmentez les répétitions ou stabilisez le scénario si son bruit dépasse le gain recherché.
R8 et les Baseline Profiles accélèrent-ils le JavaScript ?
Ils agissent sur la partie Android de l’application : code DEX et compilation ART. Ils n’optimisent pas directement le bundle Hermes. Leur effet sur la première image peut être différent de leur effet sur le moment où l’écran devient utilisable.